Étude de cas : publier un site Drupal en HTML statique, avec un blog et sa recherche
Comment ce site est édité dans Drupal avec Canvas, exporté en HTML statique avec Tome, et garde un blog avec défilement infini, filtres par catégorie et recherche Pagefind, le tout servi en simples fichiers, sans PHP ni base de données.

Ce site est mon portfolio et mon blog. Il est édité dans Drupal, mais aucun visiteur n'atteint Drupal : chaque page que vous lisez ici est du HTML statique, exporté depuis le CMS et copié sur le serveur web. Cette étude de cas explique pourquoi j'ai choisi cette approche, comment elle est construite, et ce qu'il a fallu pour garder une liste d'articles avec filtres et recherche sur un site dont le serveur web ne fait que servir des fichiers, sans PHP ni base de données.
Le contexte
Je voulais le confort d'édition d'un Drupal moderne (construction de pages avec Canvas, workflow éditorial, contenus en anglais et en français) sans exposer PHP et une base de données aux visiteurs. Un site personnel n'a pas besoin d'une application en ligne : il doit être rapide, peu coûteux à héberger et difficile à casser.
Un export statique y répond : pas de PHP, pas de base de données, pas de formulaire de connexion sur l'hôte public. La difficulté, c'est tout ce qui est dynamique : une liste d'articles avec pagination, filtres par catégorie et recherche plein texte repose normalement sur Views et la base de données.
Pourquoi le statique : la sécurité d'abord
La sécurité a été la raison décisive. En octobre 2026, PHP2Shell, des failles critiques du moteur PHP trouvées avec l'aide de l'IA, permettaient d'exécuter du code à distance sur presque n'importe quel site PHP, Drupal compris. Ce n'est qu'un exemple parmi d'autres : la recherche assistée par IA découvre des failles plus vite que jamais, et le délai entre la divulgation et l'attaque ne cesse de se réduire.
Appliquer les correctifs vite reste indispensable, mais c'est une course. Un site statique sort l'hôte public de cette course :
- Ni PHP ni base de données sur l'hôte public. Une faille du moteur comme PHP2Shell n'a rien sur quoi s'exécuter : le serveur web ne sert que des fichiers.
- Aucun formulaire de connexion, aucune route d'administration, aucune session exposés aux visiteurs : pas de bourrage d'identifiants, pas de faille de session.
- Le CMS vit sur son propre hôte. Il fait toujours tourner PHP et doit toujours être mis à jour, mais ce n'est pas lui que les visiteurs utilisent. En cas d'urgence, il peut être mis hors ligne pendant que le site public continue de tourner sans changement ; seul le formulaire de contact attend.
- Chaque page publiée est un fichier que je peux auditer.
Surtout statique, avec un formulaire de contact dynamique
Ce site est surtout du contenu : des pages de présentation et des articles de blog. Sa seule partie dynamique est le formulaire de contact : aucune raison de garder tout le site dynamique pour lui. Les pages sont statiques, et le formulaire appelle une petite API sur le CMS.
Le formulaire de contact est un webform Drupal rendu dans la page statique ; à l'envoi, du JavaScript le poste au CMS via Webform REST. L'hôte du CMS n'est pas accessible publiquement : seul ce point d'accès est joignable. Au lieu d'une application entière, la surface d'attaque se réduit à un seul point d'accès, et les pages que lisent les visiteurs restent de simples fichiers.
Objectifs et contraintes
- Éditer dans Drupal comme d'habitude : Canvas pour les pages, le formulaire d'article pour les billets, la traduction avec l'onglet Traduire.
- Ne publier que du HTML statique : le vhost public sert des fichiers, rien d'autre.
- Garder un blog utile : défilement infini, filtres par catégorie, recherche et URL partageables, y compris sur le site statique.
- Ne pas dupliquer la logique : les listes restent des vues Drupal classiques, configurées dans l'interface de Views, pas une application JavaScript à part.
- La sécurité d'abord : ni PHP, ni base de données, ni surface d'administration sur l'hôte public.
Étape 1 : éditer avec Canvas
Les pages sont construites dans Canvas à partir des Single Directory Components du thème. Les articles sont un type de contenu classique, rendu par des modèles de contenu Canvas : une mise en page pour l'article complet et une pour la carte affichée dans les listes, chaque entrée de composant étant liée à un champ.

Étape 2 : exporter et publier
Tome rend chaque page via Drupal et l'écrit en HTML.
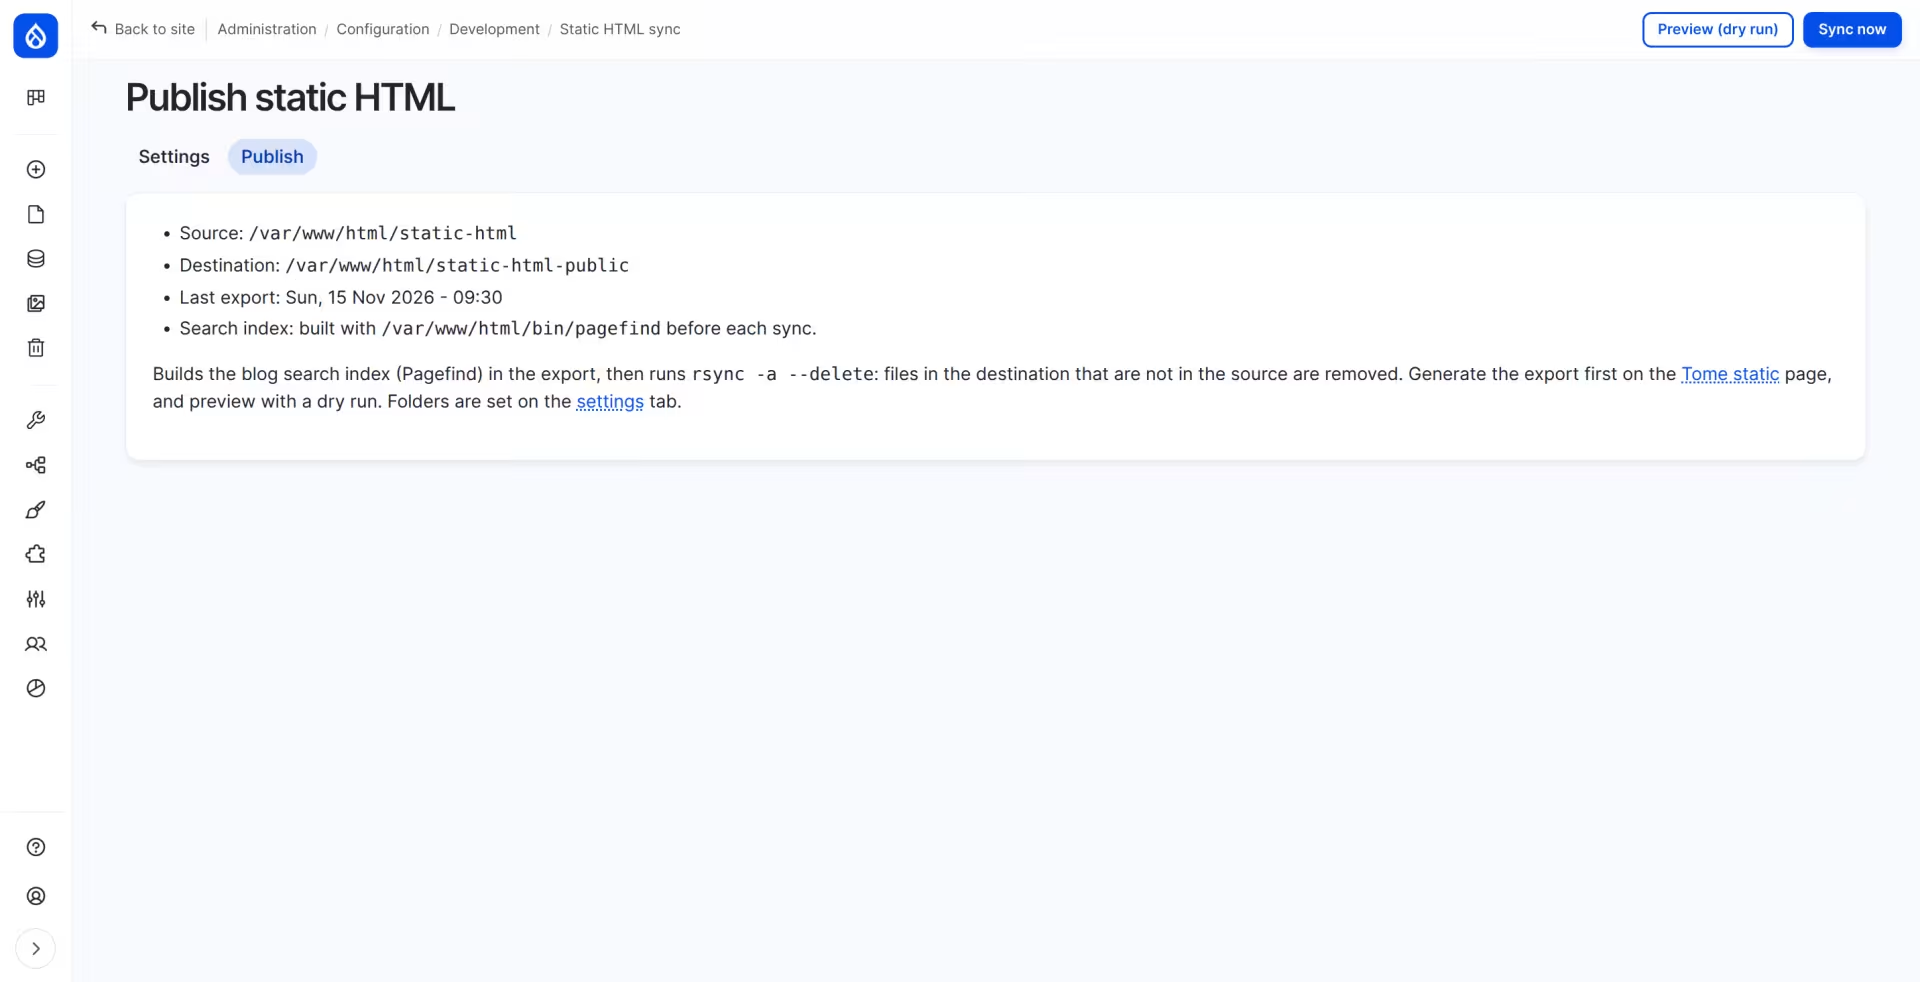
La publication est une étape séparée et volontaire, depuis une petite page d'administration : un essai à blanc liste ce qui changerait, puis rsync copie l'export vers le dossier public. Comme rsync supprime les fichiers absents de la source, la page refuse de publier un export vide, un dossier manquant ou un export dont l'index de recherche n'a pas pu être construit.
Étape 3 : une liste qui fonctionne sans base de données
La liste du blog est une vue Drupal ordinaire : articles publiés, du plus récent au plus ancien, une recherche dans le titre et des cases à cocher de catégories en filtres exposés. Un petit module sur mesure, grumpydev74_static_listing, fait fonctionner cette même vue une fois exportée :
- Défilement infini : un plugin de pagination qui suit les liens du pager, que Tome exporte comme n'importe quelle page.
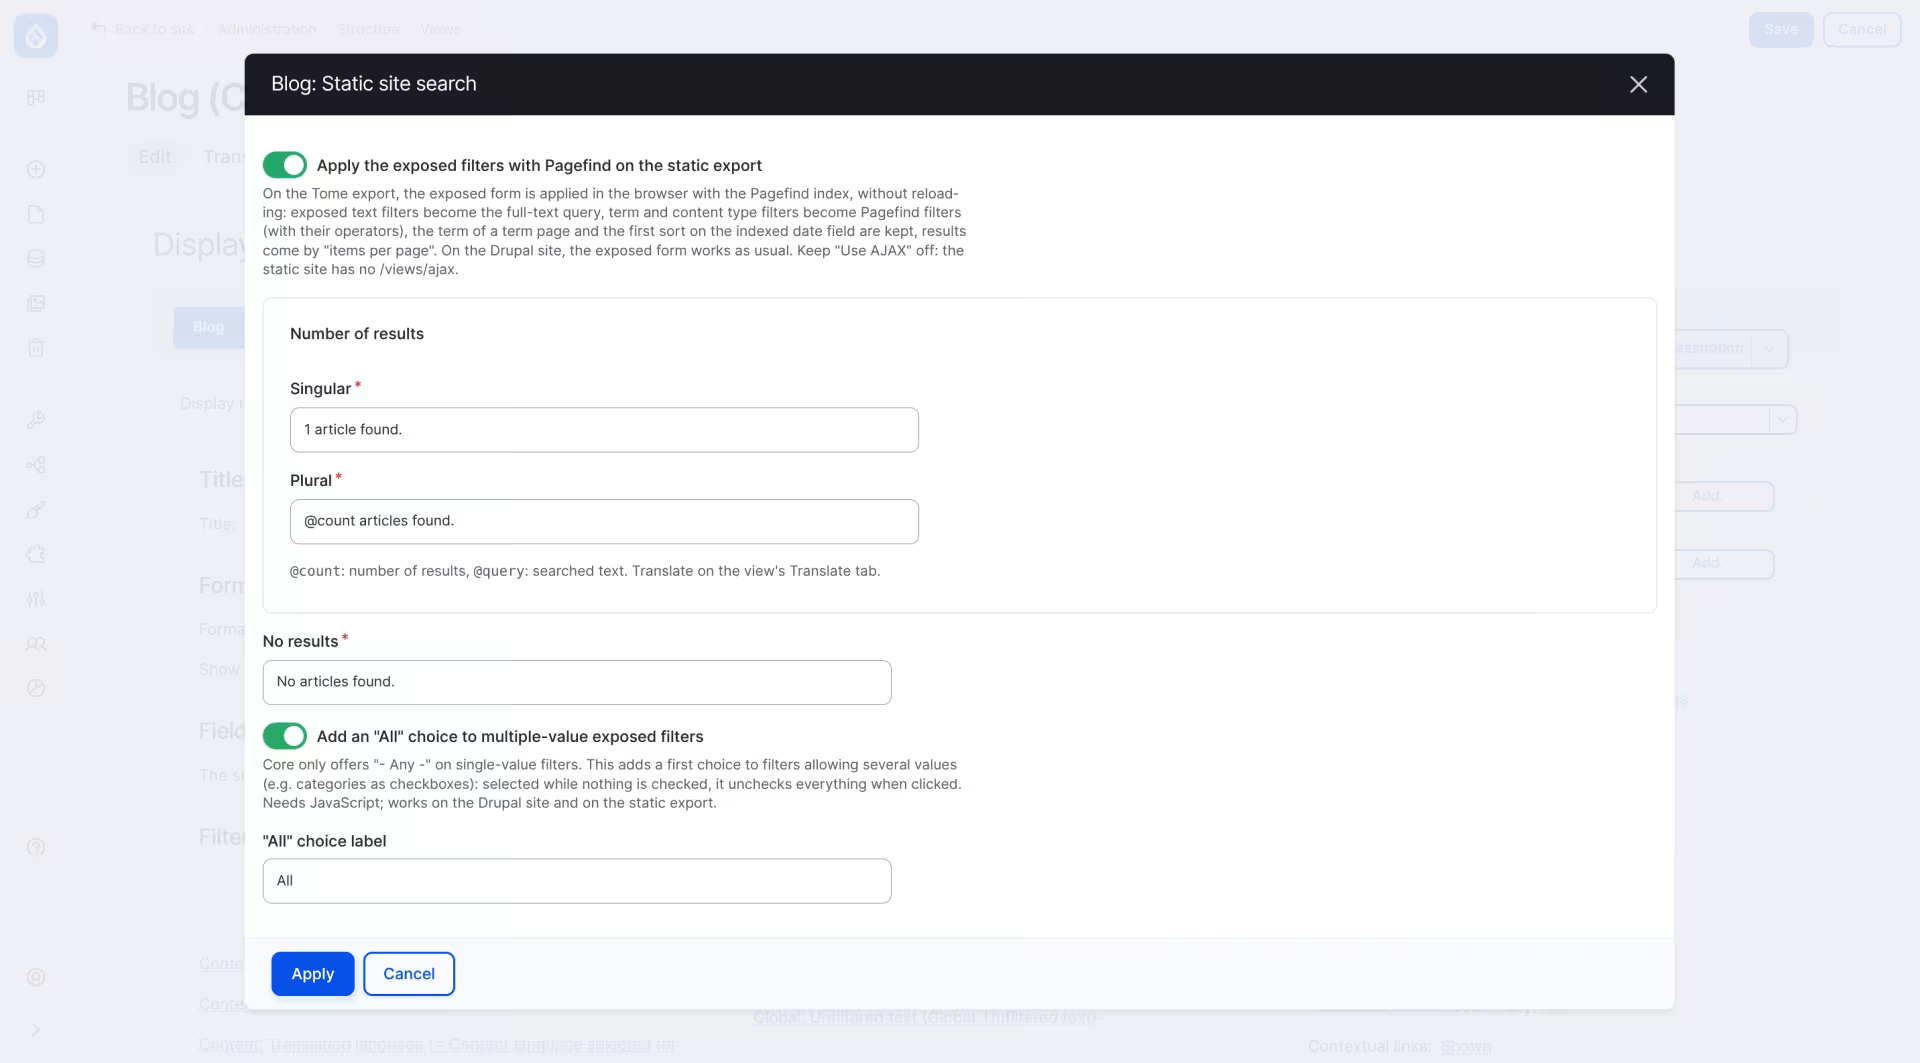
- Filtres et recherche : ils s'exécutent en base sur Drupal. Sur le site statique, le module lit les filtres exposés, le tri et le nombre d'éléments par page de la vue, et applique le même formulaire dans le navigateur.
- URL lisibles : les catégories passent par leur nom dans l'URL, par exemple /fr/blog?category=drupal+search, pour partager une liste filtrée.
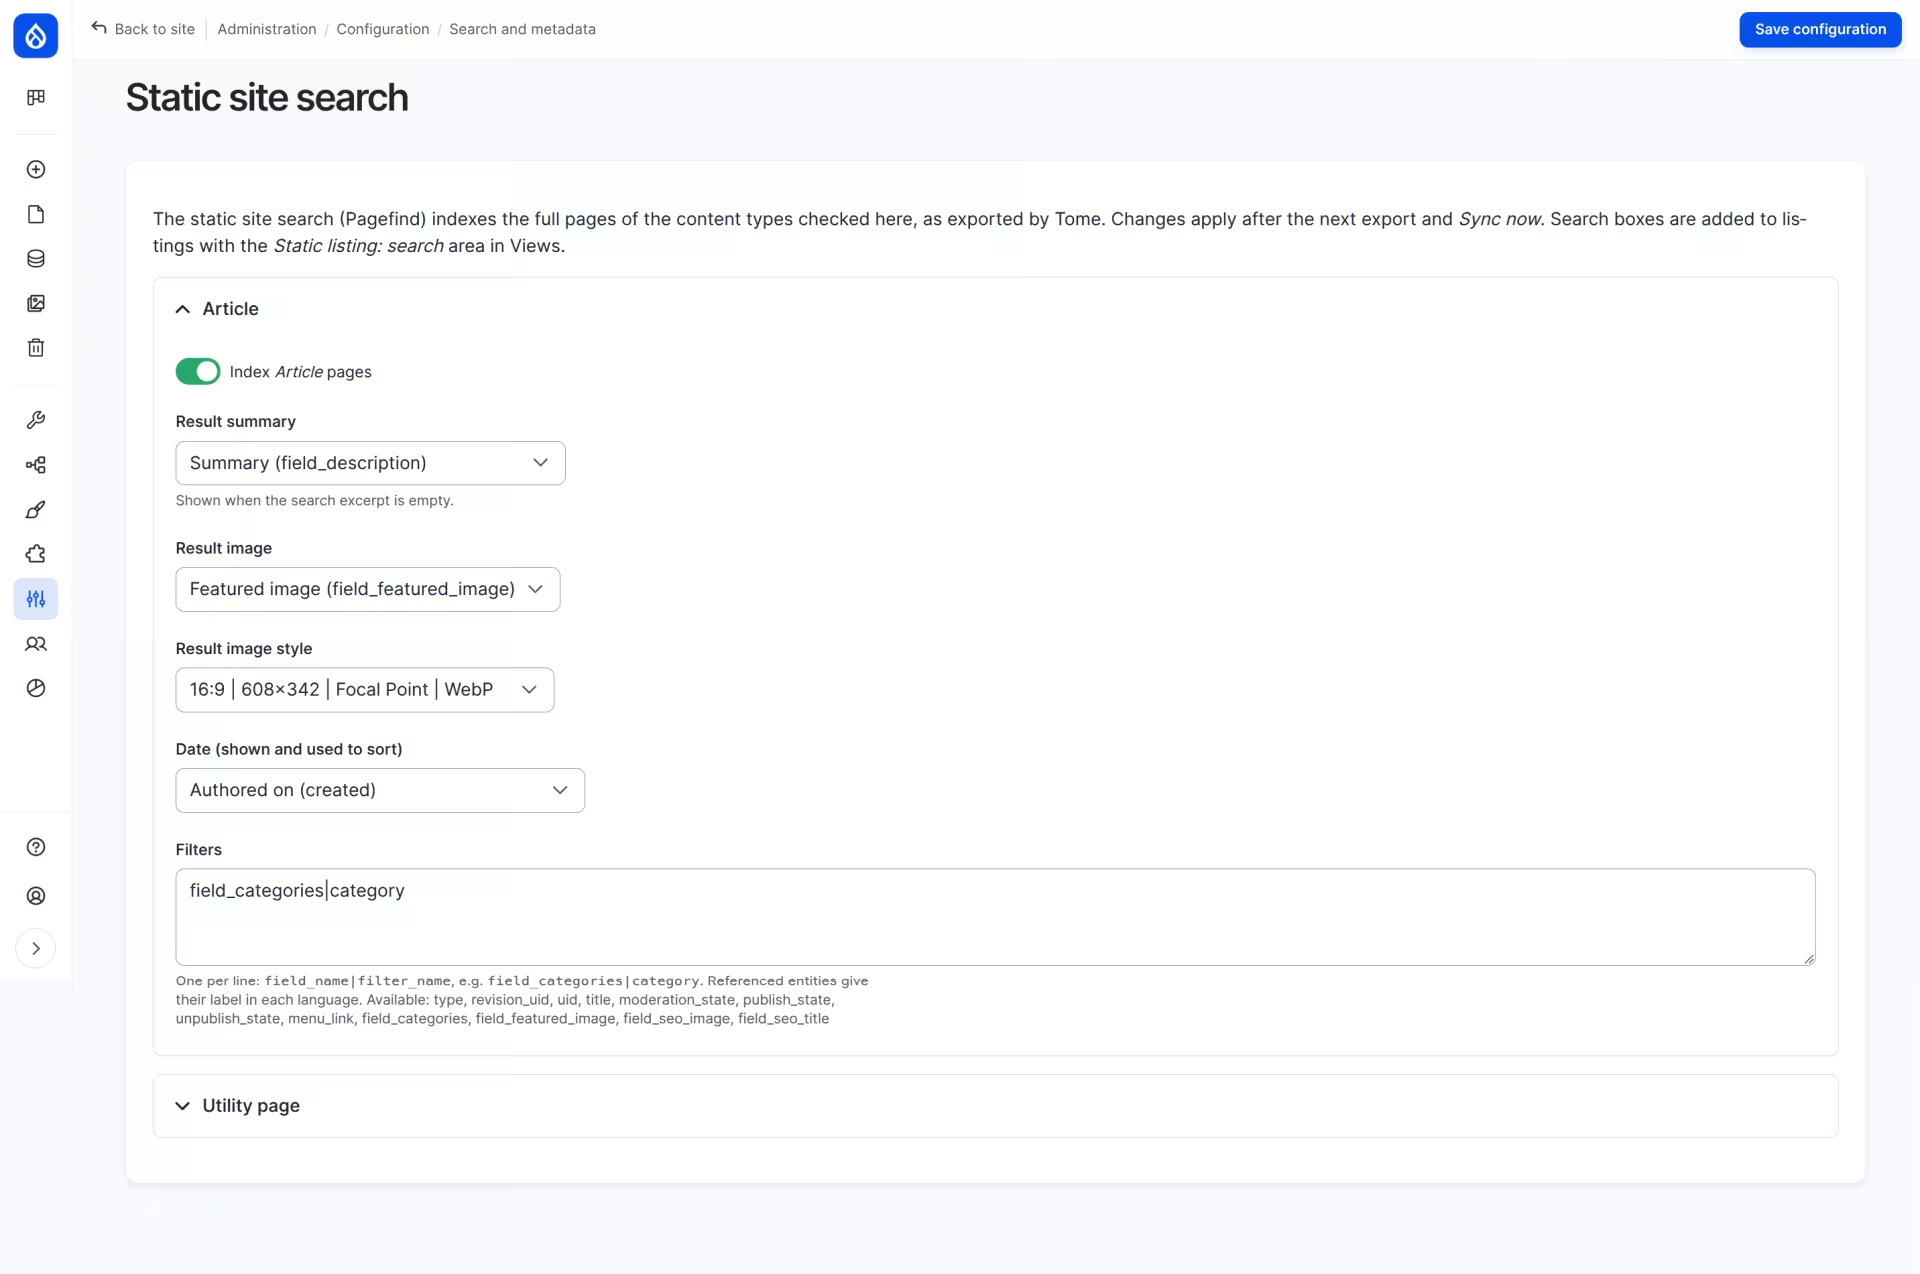
Tout se configure là où un développeur Drupal s'y attend : une option « Static site search » dans la section Autre de la vue, et une page de réglages qui choisit les champs indexés pour chaque type de contenu.
Étape 4 : la recherche avec Pagefind
Pagefind indexe le HTML exporté juste avant la publication et livre l'index sous forme de petits fichiers statiques. Le navigateur ne télécharge que les morceaux utiles à une requête : la recherche reste rapide quand le blog grandit. Les résultats reprennent le balisage des cartes d'articles, donc un résultat ressemble à un élément de la liste.
Résultats
- Une surface d'attaque bien plus réduite : le site public n'est que des fichiers HTML. Les failles du moteur comme PHP2Shell ne l'atteignent pas, et un correctif urgent à appliquer sur le CMS n'affecte pas les visiteurs.
- Les éditeurs gardent toute l'expérience Drupal : Canvas, workflow, planification, traductions.
- Le blog garde défilement infini, filtres, recherche et URL partageables, en anglais et en français.
- Le formulaire de contact reste dynamique : il est envoyé au CMS par un seul point d'accès API, la seule partie du CMS joignable de l'extérieur.
Le statique ne convient pas à tous les projets
Passer en statique n'est pas une réponse universelle. Certains projets sont dynamiques par nature : portails et intranets, espaces membres, tunnels de paiement e-commerce, tableaux de bord personnalisés, communautés avec contenus produits par les utilisateurs. Là, chaque page dépend de qui la consulte, et la bonne réponse est un Drupal durci et tenu à jour, pas un export.
Mais beaucoup de sites sont surtout du contenu, avec seulement quelques parties dynamiques. Ces parties n'obligent pas à garder tout le site dynamique : les pages peuvent être statiques, et chaque fonctionnalité dynamique peut appeler une petite API sur le CMS.
- Formulaires de contact et de demande de devis
- Inscriptions à des événements et demandes de réservation
- Inscriptions à une newsletter
- Enquêtes, sondages et formulaires de retour
- Candidatures et autres formulaires avec envoi de fichiers
- Commentaires envoyés en modération, publiés avec l'export suivant